Taalmodellen schrijven inmiddels de meeste code in mijn projecten. Ik beschrijf een wijziging, een agent schrijft hem, draait hem en opent een pull request. Stel twee keer dezelfde vraag en je krijgt twee verschillende antwoorden. Allebei met dezelfde zelfverzekerde toon.
In 2021 noemden Emily Bender, Timnit Gebru en hun co-auteurs deze systemen stochastische papegaaien: modellen die aannemelijke taal aan elkaar rijgen, getrokken uit een kansverdeling, zonder enige verankering in de vraag of het resultaat klopt. De modellen zijn sindsdien veel beter geworden. Het samplen is gebleven. Elk token is een trekking.
Dat levert een praktische vraag op. Als het ding dat mijn code schrijft niet-deterministisch is, waar komt mijn vertrouwen dan vandaan?
Mijn antwoord na een jaar op deze manier werken: ik vertrouw de controles rond het model, en die controles moeten deterministisch zijn. Zelfde invoer, zelfde oordeel, elke keer, wie of wat de code ook schreef.
Groen is een bewering
Eerst wat mislukkingen. Mensen veroorzaakten ze allemaal. Agents maken precies dit soort fouten, sneller en in grotere aantallen.
De blog die verdween. De posts op deze site komen uit een API. De loader verpakte die aanroep in catch { return [] }. Toen de API het token van de site begon te weigeren, toonde de blogpagina de melding "nog geen posts" en gaf elke post-URL een 404. Build, tests en monitoring bleven groen. Een lege pagina ziet er bewust uit.
De release met oude code. Een deploy ging door met de juiste image-tag en gezonde pods. De backend in die image was zeven commits achter de tag gebouwd. Elk signaal dat ik controleerde zei dat de release live stond. Zeven commits ervan ontbraken.
Vijf weken backups van de verkeerde database. De nachtelijke backup-job eindigde elke nacht met exitcode 0. Hij dumpte een database die na een migratie geen writes meer kreeg. De exitcode beantwoordde of het dump-commando had gedraaid. Ik wilde weten of de dump de data van vanochtend bevatte.
Een typechecker die nooit draaide. De API wordt gebundeld met esbuild, dat TypeScript-types weghaalt zonder ze te controleren. Build, lint en tests slaagden terwijl er zo'n 1.370 typefouten in de code zaten, en bij elke release kwamen er nieuwe bij in productie.
Elk van deze gevallen is een groene check die een smallere vraag beantwoordt dan de vraag die ik dacht te stellen. Een agent heeft dezelfde blinde vlek, en vertelt je vloeiend dat het werk af is.
Poorten waar het model zich niet langs kan praten
Je kunt een agent vertellen "push nooit zonder de tests te draaien". Die zin belandt in een contextvenster en wordt één invoer tussen duizenden voor een sampler. Meestal houdt hij stand. "Meestal" is een kans.
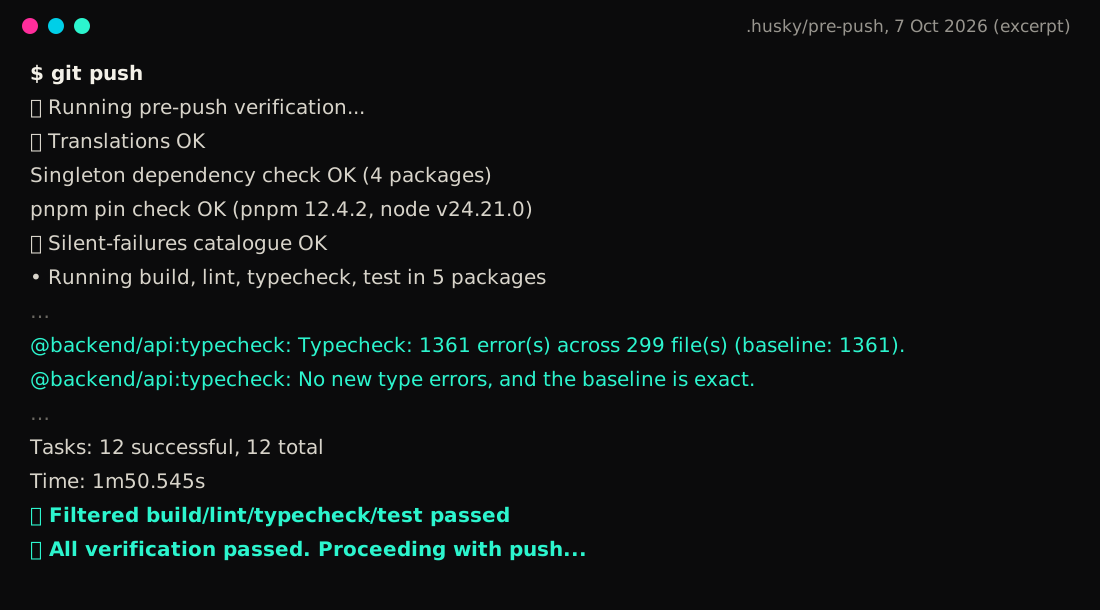
Dus de regel staat in een pre-push hook. Elke push draait build, lint, typecheck en tests, en een fout blokkeert de push. De instructies voor agents zeggen nog steeds dat ze --no-verify nooit mogen gebruiken. Die instructie is de beleefde versie van de regel. De hook is de afgedwongen versie. Hij geeft hetzelfde antwoord aan mij, aan een agent, en aan een agent die om drie uur 's nachts heeft besloten dat de falende test niets met zijn wijziging te maken heeft.
De algemene vorm: elke regel die je belangrijk vindt, hoort te bestaan als een programma dat een oordeel teruggeeft. Prompts en richtlijnen beschrijven de bedoeling. Programma's dwingen die af.
Shift left, tot in de loop van de auteur
Hoe eerder een check draait, hoe goedkoper de fix. Developers weten dat al tientallen jaren: een rode kronkel in je editor kost seconden, en dezelfde bug die een collega in een review vindt kost een gesprek. Agents maken het scherper. Een test die faalt op de machine van de agent, vóór de push, komt als platte uitvoer in zijn context terecht: bestand, regel, verwacht, gekregen. De agent leest het, probeert opnieuw, en ik zie de fout nooit. Dezelfde fout in CI kost een rondje heen en weer. In staging kost hij een onderzoek. Bij een gebruiker kost hij vertrouwen.
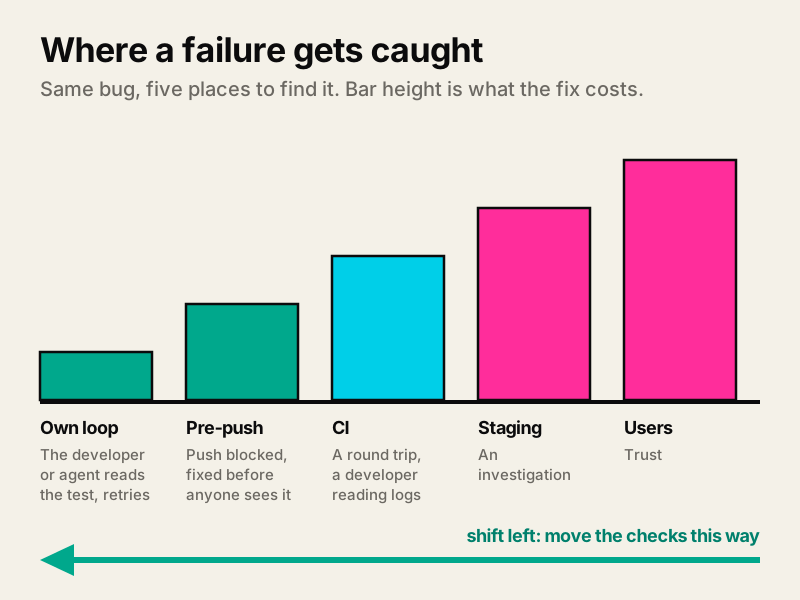
De checks zijn voor allebei de soorten auteurs dezelfde. De hook die een agent tegenhoudt, houdt mij ook tegen, en een foutmelding die een agent vertelt hoe hij iets oplost, vertelt de volgende developer hetzelfde. Dus schuiven de checks zo dicht mogelijk naar de wijziging. Typefouten, lint en unittests draaien vóór een push. Tests staan naast de code die ze dekken, zodat wie een bestand aanpast, developer of agent, de test in dezelfde map vindt. Regels die vroeger in reviewcommentaar stonden, zoals "slik deze fout niet in" of "log via de gestructureerde logger", werden CI-checks met een foutmelding die zegt wat je moet doen. Een check die zijn eigen oplossing uitlegt, kan worden afgehandeld door wie hem liet afgaan, zonder op een reviewer te wachten.
Shift left heeft een grens: een pre-push hook ziet de code, en echte gebruikers nemen nog steeds paden die geen test beschrijft.
Een ratel op de schuld
De typechecker kon niet van de ene op de andere dag een poort worden, want een harde grens van nul fouten betekende eerst weken opruimen. Dus werd het een ratel. Een baselinebestand in de repository legt vast hoeveel fouten elk bestand mag hebben. Een bestand dat fouten erbij krijgt, faalt. Een schoon bestand dat fouten gaat geven, faalt. Een bestand met minder fouten dan toegestaan faalt ook, totdat iemand het lagere getal commit.
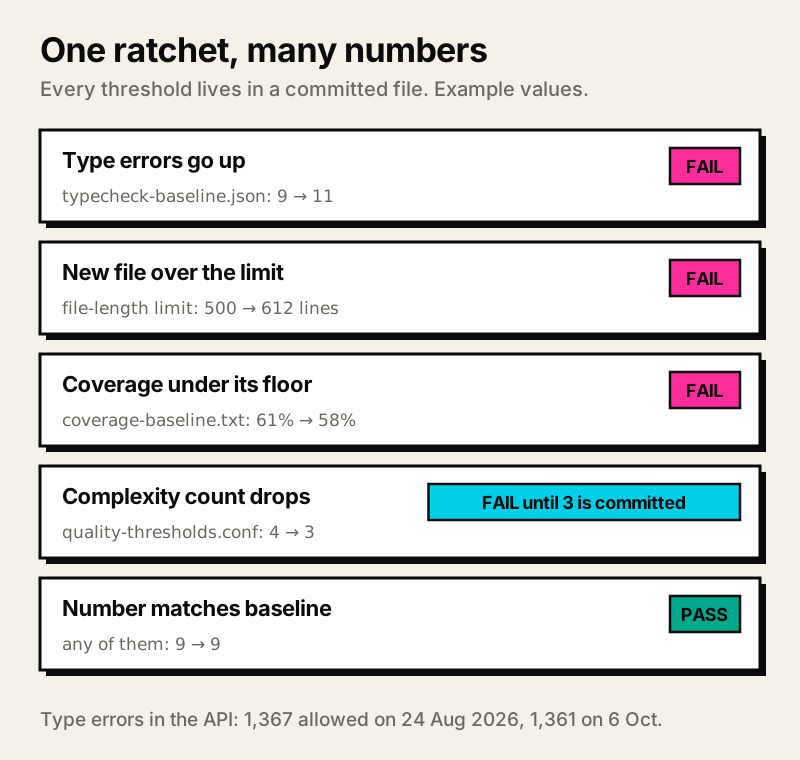
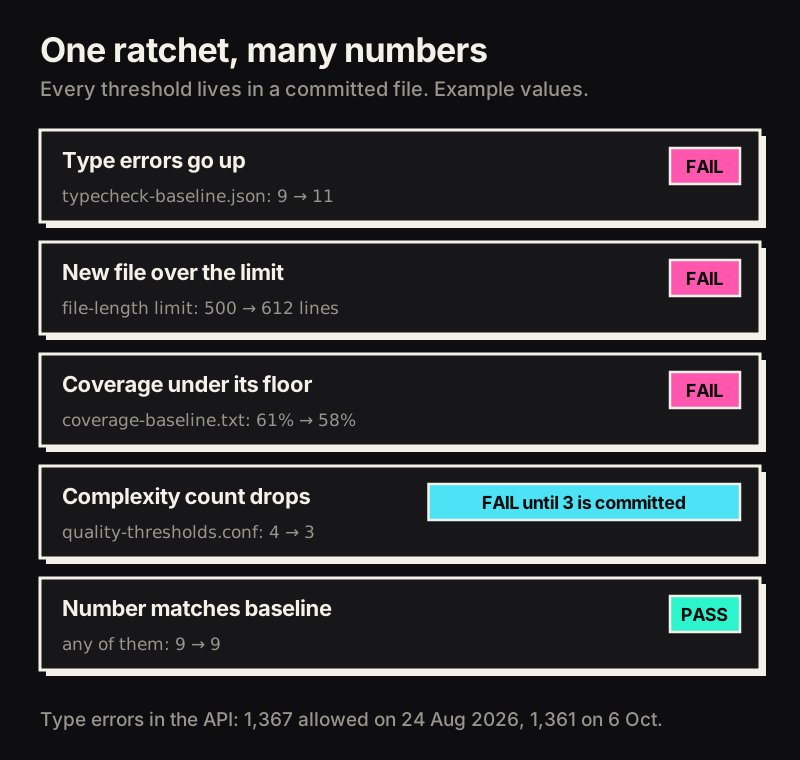
Zonder die derde regel laat het oplossen van vijf fouten ruimte voor vijf nieuwe, en blijft CI hoe dan ook groen. Met die regel wordt elke verbetering de nieuwe bodem. De schuld ligt vast, is zichtbaar en kan alleen nog dalen.
Typefouten waren de eerste. Dezelfde vorm geldt nu voor de meeste getallen die ik belangrijk vind, verspreid over mijn repositories: bestandslengte, functielengte, cyclomatische complexiteit, gedupliceerde code, lint-meldingen en unittest-coverage. Coverage werkt andersom, dus daar kan de bodem alleen stijgen. Elke drempel staat in een gecommit bestand. In SpanBarn weigert de gate te draaien als er een drempel in de omgeving staat, dus COMPLEXITY=99 make quality-gate faalt, en een getal verplaats je alleen met een diff die iemand reviewt. Elke gate draait ook eerst zijn eigen tests, want een ratel die stilletjes niet meer faalt, ziet er precies zo uit als een geslaagde check.
Ratels passen goed bij agents. Ze maken van een vaag doel als "verbeter de types" een vergelijking met een getal in de repository, en de diff van de baseline laat precies zien welke bestanden beter of slechter werden.
Controleer het artefact
Na de release met oude code veranderde de deploy-check: hij zoekt nu in de draaiende bundle naar iets wat de release introduceerde. Na het backup-incident telt de backup-check rijen in de dump en vergelijkt die met de live database. Toen twee ingresses dezelfde hostname claimden en de router per request er één koos, werd een simpele curl naar de publieke URL een gok, dus deploy-checks praten nu direct met de pod of de service.
Het patroon herhaalt zich. Meet wat je wilt weten, op de plek waar het draait. Een statuscode, een tagnaam of een exitcode is een benadering, en benaderingen lopen uit de pas.
Maak fouten luid en stabiel
Elk foutpad in mijn projecten logt op error-niveau via een gestructureerde logger en meldt zich bij BugBarn, de error tracker die ik zelf draai. De return [] in de blog-loader meldt de fout nu voordat hij terugvalt.
Luid is de helft. De andere helft is stabiel. BugBarn groepeert fouten op een fingerprint waar de foutmelding in zit. Eén bug in een contentpipeline zette per-item-data in zijn foutmelding en leverde veertig losse issues op, die elk klein leken. Met een vaste melding en de details op het error-object wordt dezelfde bug één issue met een oplopende teller. Deterministisch groeperen laat een mens, of een agent die de issuelijst leest, zien dat één probleem erger wordt.
Een uitlezing van de echte flow
Tests beschrijven de paden waar ik aan dacht. Gebruikers nemen de andere. Als een flow misgaat bij één op de vijftig gebruikers, luidt de melding meestal iets als "het formulier blijft soms hangen", en met die zin kan een agent net zo weinig als ik.
Telemetrie maakt van die zin een registratie. De API draait OpenTelemetry. HTTP, Fastify en Postgres worden automatisch geïnstrumenteerd, en een kleine withSpan-helper omhult de bedrijfsstappen die de automatische instrumentatie mist, zoals zoekopdrachten, auth-aanroepen en uploads. Een falende span draagt de fout en de stacktrace mee. De spans gaan naar SpanBarn, mijn trace-opslag. Aan de frontendkant neemt FunnelBarn sessies op, zodat ik zie waar iemand op klikte en wat die te zien kreeg.
Als een flow raar doet, open ik de trace. Die toont elke stap van dat ene request op volgorde, met tijden, en markeert de stap die faalde. De trage zoekopdracht, de auth-aanroep die drie keer opnieuw probeerde, de upload die verliep toen de gebruiker al weg was: het staat allemaal in één waterval. Het gissen houdt op.
Een echte gebruikersflow is ongeveer het meest niet-deterministische wat er bestaat: timing, netwerk, data, een dubbelklik. De trace is een vaste registratie van één keer dat die flow liep. Hij leest elke keer hetzelfde, en ik kan een agent het trace-ID geven. De agent begint dan bij bewijs van wat er gebeurde.
Instrumentatie hoort in dezelfde pull request als de feature. Een flow die zonder spans live gaat, kun je alleen debuggen door te gissen. Mijn volgende stap is de tracecontext vanuit de browser meegeven aan de API, zodat één trace zowel de klik als de databasequery erachter omvat.
Flaky tests leren iedereen opnieuw proberen
Een flaky test is een niet-deterministische poort. Hij leert iedere lezer dat rood "probeer het nog eens" betekent, en agents pikken die les snel op.
Het ergste geval dat ik heb gezien begon bij een agent die een timing-afhankelijke test onderzocht. Hij wilde de fout reproduceren onder CPU-druk en startte twaalf busy loops op de achtergrond. Die overleefden de tool-aanroep, de agent en de sessie. Dezelfde machine draait de CI-runners voor de meeste van mijn projecten. Zo'n veertien uur lang stond de load average op 148. Een testshard van twee minuten duurde bijna twee uur, en twee releases werden tegengehouden door checks die flaky leken.
De oplossing voor de oorspronkelijke test was wachten op de echte async-overgang, zodat de uitkomst niet meer van timing afhing. Er is nu een geschreven regel tegen het genereren van kunstmatige load, en een nuttigere: controleer de load van de host voordat je een rode job opnieuw draait. Eén herhaling mag. Faalt hij weer, dan stop je en zoek je de oorzaak.
Beperk wat een fout antwoord kan aanrichten
Een check vangt sommige fouten. Andere moeten onmogelijk zijn. Ik schreef eerder over onzichtbare prompts en hoe makkelijk een agent instructies volgt die hij zou moeten negeren. Ook daar is de verdediging deterministisch: least privilege, afgebakende credentials, en een menselijke goedkeuring voor alles wat geld kost, echte mensen mailt of niet terug te draaien is. Uitgaande e-mail op mijn platform gaat door een feature flag die voor elke nieuwe categorie standaard uit staat. Een agent kan niet onderhandelen met een flag die hij niet mag aanpassen.
Waarom ik de tools zelf bouw
BugBarn, SpanBarn en FunnelBarn zijn mijn eigen projecten, en alle drie zijn open source:
- BugBarn voor error tracking (GitHub)
- SpanBarn voor traces
- FunnelBarn voor analytics, feature flags en sessie-opnames (GitHub)
Gehoste tools als Sentry, Honeycomb en PostHog doen dit werk goed, en er zelf versies van bouwen is, met elke redelijke maatstaf, een beetje gek.
Ze zijn een experiment met agents die software bouwen en die in een loop verbeteren. Agents schrijven het grootste deel van hun code. De tools houden zichzelf ook in de gaten: BugBarn meldt zijn eigen fouten aan zijn eigen dashboard, en de CLI geeft issues terug als JSON, zodat een agent de issuelijst kan lezen, een issue kan oppakken, het kan oplossen en de fix kan uitrollen via dezelfde bewaakte pipeline als al het andere. Omdat de tools van mij zijn, bepaal ik wat de agent te lezen krijgt, tot aan de vorm van een foutmelding.
Die loop leunt op alles wat eerder in deze post staat. Een systeem dat zichzelf verbetert, drijft af waar de sampler het heen stuurt, tenzij deterministische checks bepalen welke wijzigingen als verbetering tellen.
Wat de barns me leerden
De tools meten elkaar en zichzelf. BugBarn stuurt zijn traces naar SpanBarn met tail-based sampling: elke trace met een fout erin wordt bewaard, plus tien procent van de rest. FunnelBarn meldt zijn fouten aan BugBarn. Een paar dingen die die loop opleverde:
Een optimalisatie die BugBarn trager maakte. De ingest van BugBarn loopt via een write queue. Een reeks wijzigingen ging zowel de producer als de consumer batchen om de doorvoer te verhogen. De tests slaagden en op papier klopte het ontwerp. In productie komen events één of twee tegelijk binnen, dus de batches van de producer liepen nooit vol, en de consumer hield een lock vast terwijl hij grote batches item voor item afwerkte. De queue liep langzamer leeg dan daarvoor. De wijzigingen zijn teruggedraaid, en dezelfde pull request voegde drie metrics toe: de diepte van de queue, verwerkte items per soort en uitkomst, en de opslagtijd per soort. De volgende regressie van dit type verschijnt als een lijn in een grafiek.
Zes seconden per event. Zodra de opslagtijd per soort werd gemeten, was het verschil moeilijk te missen: logs werden in microseconden opgeslagen, events deden er zo'n zes seconden over. De oorzaak was een check die elke passende rij telde om te weten of er minstens één bestond, en die draaide per facet, per event. COUNT(*) vervangen door EXISTS maakte er één index-lookup van. Een regressietest controleert nu dat de query de index gebruikt, zodat de fix blijft werken.
SpanBarn als eerste plek om te kijken. Trage databasequeries verschijnen in SpanBarn als lange spans, met de query erbij. Meer dan eens begon de oplossing voor een trage BugBarn-pagina daar en eindigde hij als een nieuwe index. Een ander project van mij stuurt zijn LLM-aanroepen ook naar SpanBarn, met de prompt, het model, het aantal tokens en de latency op elke span. Prompts tunen wordt dan een voor-en-na-vergelijking op echt verkeer. Frontends melden hun Core Web Vitals, en services krijgen een Apdex-score. Voelt een pagina traag of verspringt de layout tijdens het laden, dan laat SpanBarn zien welke pagina, welk element en sinds welke release.
Van een trace naar wat de gebruiker zag. De drie tools delen één sleutel: het W3C trace-ID. De FunnelBarn-SDK legt het actieve trace-ID vast naast de sessie-opname, zodat FunnelBarn een trace-ID kan herleiden tot een opname en het moment waarop die trace afging. Een kleine replay-CLI neemt een trace-ID uit SpanBarn of BugBarn, haalt de opname op en speelt die af in een headless browser, gespoeld naar dat moment, met de optie om een screenshot op te slaan. Een error-span wordt een paar seconden beeld van wat de gebruiker op dat moment deed.
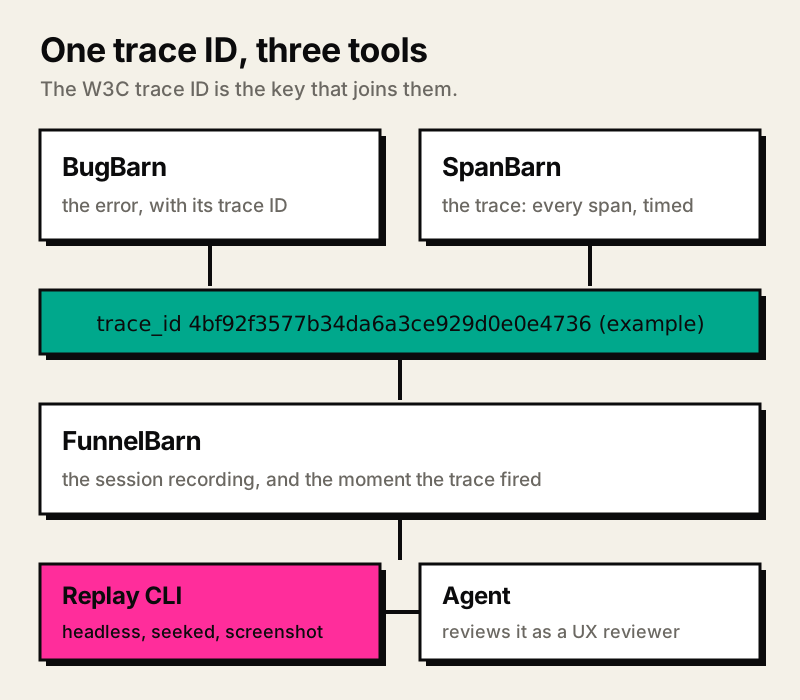
Die CLI heeft geen mens achter het toetsenbord nodig, en dat maakt hem het volgende experiment. Het plan: een agent pakt het trace-ID van een fout, speelt de sessie af, bekijkt de screenshots en leest de trace ernaast. Hij krijgt de opdracht van een senior UX-reviewer en één vraag: wat ging er mis voor deze gebruiker? Waar die op klikte, wat het scherm op dat moment liet zien, welke melding verscheen of juist uitbleef. Hij stelt een wijziging voor, en die wijziging gaat door dezelfde poorten als elke andere. De MCP-server van FunnelBarn geeft een agent nu al de funnels en conversiecijfers, zodat hij achteraf kan nagaan of de wijziging hielp.
De les van het experiment tot nu toe: een agent kan een product verbeteren zo ver als de uitlezingen reiken. Daarbuiten gist hij, net als ik zou doen.
Waar de papegaai thuishoort
De willekeur heeft zijn plek. Hij helpt waar variatie goedkoop is: een ontwerp verkennen, code schetsen, drie aanpakken voor een bug voorstellen, de eerste versie van een test schrijven. Daar wil ik dat het model vindingrijk is.
Variatie wordt duur aan de grenzen: mergen, deployen, data migreren, geld uitgeven, mensen benaderen. Die grenzen krijgen deterministische poorten, en die poorten behandelen elke auteur hetzelfde.
Menselijke teams werken altijd al zo. Code review, CI, gefaseerde uitrol en backups bestaan omdat mensen fouten maken. Die werkwijzen gingen uit van een auteur die een paar honderd regels per dag schrijft. De auteur schrijft er nu duizenden, dus de checks moeten snel, streng en saai zijn.
Het model stelt voor. De pipeline beslist.